

Visibilidad en IA: la cifra que el cliente nos pide no existe
Cada vez más clientes nos piden lo mismo: «quiero un informe de mi posición en ChatGPT, igual que el que me dabais de Google» o nos contactan empresas que quieren saber cómo mencionan sus contenidos o citan su marca. La respuesta corta es que ese dato, con la precisión con la que se pide, no existe. No es que falte una herramienta lo bastante buena todavía. Es que las respuestas de los modelos de lenguaje son, por diseño, probabilísticas y personalizadas, justo lo contrario de lo que necesitarías para medir algo con exactitud.
Esto no significa que no haya nada que medir. Significa que hay que cambiar la pregunta. En este artículo voy a repasar la evidencia científica que lo demuestra, por qué ni siquiera las herramientas más caras del mercado pueden resolverlo, y qué es lo único que sí tiene sentido medir hoy.
Qué es la visibilidad en IA y por qué no es comparable al rank tracking
La visibilidad en IA es la frecuencia y la forma en que una marca aparece citada, recomendada o mencionada en las respuestas de ChatGPT, Perplexity, Gemini, Copilot o los AI Overviews de Google cuando alguien pregunta por su sector. Los «prompt trackers» (Otterly, Peec AI, Profound, Semrush AI Visibility, Ahrefs Brand Radar, entre otros) son las herramientas que intentan medirlo lanzando prompts predefinidos contra esos modelos.
El problema de fondo es de expectativa, no de herramienta. En Google, una palabra clave tenía una posición: 1, 5 ó 20. Esa cifra era estable de un día para otro y verificable en Search Console. En una respuesta conversacional de IA no hay equivalente. La misma pregunta, hecha dos veces seguidas, puede devolver una lista de marcas distinta, en otro orden y con un número diferente de resultados. El propio Jesse Dwyer, Chief Content Officer de Perplexity, ha reconocido en una entrevista con el Wall Street Journal que la búsqueda con IA personaliza los resultados según quién pregunta, lo que la hace difícil de predecir y de medir (esto lo dice un ejecutivo de la plataforma).
2. La evidencia: los LLM no dan la misma respuesta dos veces
Ni siquiera con «temperatura cero»
Existe la creencia extendida de que fijar el parámetro temperature en 0 hace que un modelo sea determinista. No es así. Un estudio publicado en ACM Transactions on Software Engineering and Methodology (2025) encontró que ChatGPT, configurado con temperature=0, produjo dos outputs idénticos en menos del 25% de los casos al repetir tareas de generación de código (confianza: alta, revisión por pares).
En la misma línea, un estudio de Wang y Wang (2025) analizó 3,4 millones de outputs a lo largo de 50 ejecuciones independientes por tarea. Los modelos más recientes no salieron mejor parados: GPT-4o repitió exactamente la misma respuesta solo el 3% de las veces, frente al 97% de GPT-3.5 Turbo. Los autores recomiendan un mínimo de 3 a 5 ejecuciones simultáneas por prompt para poder hablar de consistencia estadística (confianza: alta, metodología descrita y muestra amplia).
Ver El modo IA de Google cambia el 91 % en las URL en búsquedas repetidas
Los errores no son independientes entre sí
Un paper de Anthropic sobre metodología estadística en evaluaciones de modelos (Miller, 2024) demuestra que cuando las preguntas de una evaluación están agrupadas por tema, sus resultados están correlacionados entre ellas. Aplicado a un prompt tracker, esto significa que si un modelo tiene un sesgo hacia o contra tu marca en el tema «software CRM», ese sesgo se repetirá de forma sistemática en todos los prompts sobre CRM. Treinta prompts relacionados con tu sector no equivalen a treinta observaciones independientes, sino a bastantes menos (confianza: alta, el mecanismo estadístico está publicado y es replicable; la equivalencia exacta en número de observaciones «efectivas» para un prompt tracker concreto no está documentada públicamente por ningún proveedor).
El estudio que más debería preocupar a quien vende certeza
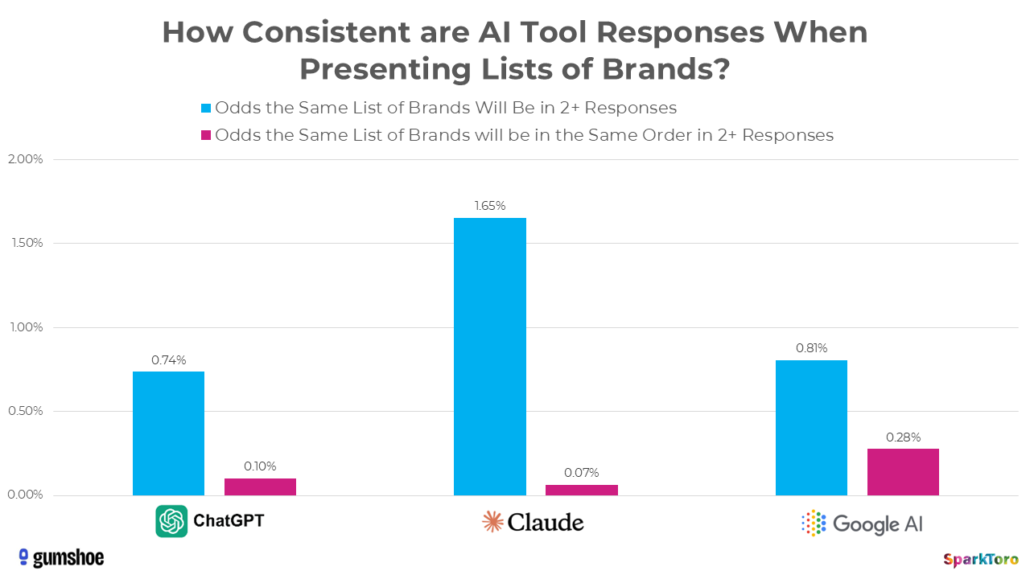
En enero de 2026, Rand Fishkin (SparkToro) y Patrick O’Donnell (Gumshoe.ai) publicaron el estudio más amplio hasta la fecha sobre consistencia de recomendaciones de IA: 600 voluntarios ejecutaron 12 prompts idénticos en ChatGPT, Claude y la IA de Google, un total de 2.961 ejecuciones, en 12 categorías distintas. Los resultados, confirmados de forma independiente por SparkToro, Search Engine Journal y MediaPost:
| Qué se midió | Resultado |
| Probabilidad de obtener la misma lista de marcas dos veces | Menos de 1 entre 100 |
| Probabilidad de obtener la misma lista en el mismo orden | Menos de 1 entre 1.000 |
| Tamaño de la lista devuelta | Varía entre 2 y más de 10 marcas según la ejecución |
El propio Fishkin matiza algo importante: aunque el orden y la lista exacta son prácticamente aleatorios, el porcentaje de apariciones agregado de una marca a lo largo de muchas ejecuciones sí puede ser un indicador con algo de validez estadística. Es la métrica menos mala, no una métrica fiable en términos absolutos.
La volatilidad de las citas: entre el 30% y el 60% cambia cada mes
Profound analizó cerca de 80.000 prompts por plataforma comparando dos meses consecutivos y encontró que entre el 40% y el 59% de los dominios citados cambiaron de un mes a otro según la plataforma (Google AI Overviews, ChatGPT, Copilot, Perplexity). Otro análisis independiente sobre 230.000 prompts a lo largo de 13 semanas, realizado por Semrush, documentó un caso muy concreto: en agosto de 2025, ChatGPT citaba Reddit en cerca del 60% de sus respuestas; en septiembre, ese porcentaje cayó a alrededor del 10%, sin que ninguna marca citada hubiera cambiado nada en su contenido. El cambio vino de un ajuste interno del modelo.
Esto es clave para gestionar expectativas: si tu visibilidad cae un mes, no siempre es un problema tuyo. Puede ser un cambio de criterio interno del modelo que no tiene relación con tu contenido ni con tu estrategia.
Por qué ninguna herramienta externa puede ver lo que ve tu usuario
Cuando un usuario pregunta algo a ChatGPT o a Google, el sistema no ejecuta esa pregunta de forma literal. Genera varias subconsultas internas («query fan-out»), decide si necesita buscar en la web o si puede responder con su conocimiento ya entrenado, y ajusta el resultado según el histórico de conversación, la ubicación del usuario o si tiene herramientas externas conectadas (Gmail, Drive, un CRM).
Google, por ejemplo, tiene patentada esta lógica de fan-out (US20230281193A1) y de organización temática de resultados (US12158907B1): analiza qué buscó el usuario antes, dónde está y cómo reformuló consultas anteriores, todo en tiempo real. Ningún prompt lanzado desde fuera, por bien diseñado que esté, puede reproducir ese contexto. Un análisis de Ahrefs sobre 863.000 SERPs encontró que solo el 38% de las páginas citadas en AI Overviews aparecían también en el top 10 orgánico para esa misma consulta. El 62% restante procede de fan-outs internos a los que ninguna herramienta de terceros tiene acceso (confianza: media-alta, dato de un proveedor comercial, pero con metodología y tamaño de muestra descritos).
A esto se suma que la mayoría de herramientas de tracking no distinguen si la respuesta vino de una búsqueda en tiempo real o del conocimiento ya almacenado en el modelo. La diferencia es crítica para decidir qué hacer: si vino de búsqueda, se puede optimizar contenido; si vino del conocimiento paramétrico del modelo, no hay nada que hacer hasta el próximo ciclo de entrenamiento.
Las métricas del mercado no significan lo mismo entre sí
Incluso asumiendo que una herramienta ejecuta suficientes prompts, el problema no desaparece: cada proveedor calcula sus métricas con una fórmula distinta y no hay ningún estándar de la industria.
- Visibility score. Geneo lo calcula como presencia × 0,5 + prominencia × 0,3 + clics esperados × 0,2. Advanced Web Ranking asigna 100% a la posición 1 y 10% a la posición 10. Surfer lo define como menciones de marca dividido entre respuestas de IA analizadas. Un 45 en una herramienta no es comparable con un 45 en otra.
- Share of Voice. Se calcula como menciones de tu marca dividido entre menciones totales de tu marca más las de tus competidores. El problema es que tú decides qué competidores entran en ese denominador. Añade uno y tu SoV baja sin que haya cambiado nada en el mercado real.
- Posición. En una respuesta de 500 palabras que menciona a cinco marcas, ¿cuál es la «posición 1»? ¿La primera mencionada? ¿La más repetida? No hay una convención compartida entre plataformas.
- Volumen de búsqueda de prompts. Ninguna empresa fuera de OpenAI, Google o Anthropic tiene acceso a los datos reales de qué preguntan los usuarios en un chat de IA. Lo que muestran estas herramientas como «AI Search Volume» es una estimación modelada, no un dato medido. El propio Ahrefs lo reconoce en su documentación pública: no existen datos reales de demanda para ChatGPT.
Qué sí podemos medir con un mínimo de rigor
No se trata de renunciar a medir, sino de medir lo que realmente aporta señal:
Datos de primera parte, cuando existen. Bing Webmaster Tools lanzó en 2026 su informe «AI Performance«, que muestra qué URLs fueron citadas por Copilot y Bing AI en respuestas reales a usuarios reales, con qué frecuencia y con qué consultas agregadas («grounding queries»). No mide tráfico ni conversiones, y los datos están muestreados, pero es la primera fuente de datos reales (no estimados desde fuera) disponible para visibilidad en IA. Si Google o OpenAI extienden algo similar a Search Console, será el punto de inflexión de esta disciplina.
Tracking a escala masiva, para detectar gaps de contenido, no «tu ranking». Herramientas como SISTRIX (hasta 50 millones de prompts por idioma), Ahrefs Brand Radar (190 millones al mes) o Semrush AI Visibility (100+ millones) sí tienen volumen suficiente para detectar patrones reales en lugar de ruido estadístico. No sirven para saber «si hoy apareces en la posición 2», pero sí para detectar que un competidor está siendo citado en un clúster temático entero (por ejemplo, «software de contabilidad para autónomos») en el que tu marca no aparece. Eso es una señal de contenido que vale la pena investigar, con independencia de la cifra exacta de visibilidad.
Recuerda que estas herramientas son de pago. El precio y las prestaciones es muy variable y puede ir desde unos 19 euros hasta los 199 euros.
Porcentaje de aparición agregado, como indicador direccional. No para un solo prompt lanzado una vez, sino como tendencia a lo largo de docenas de ejecuciones y semanas. Sirve para detectar dirección (mejora o empeora), no para fijar un objetivo numérico exacto.
Menciones de terceros que te citan, no solo tu propio dominio. El valor real de estas herramientas suele estar en descubrir que un medio o comparativa externa te menciona en un contexto que un keyword gap tradicional (comparando solo dominios propios) nunca detectaría.
Cómo lo planteamos en SEO In House
Cuando un cliente nos pide «el informe de visibilidad en ChatGPT», no le decimos que no se puede hacer nada. Le explicamos todo esto y qué tipo de dato es razonable esperar y con qué margen de error. En la práctica, podemos entregar 3 tipos de datos:
- Auditoría de gaps de contenido por clúster temático, usando herramientas de escala masiva para identificar dónde la competencia aparece citada y él no.
- Seguimiento de porcentaje de aparición agregado sobre un conjunto de prompts reales del sector, reportado como tendencia trimestral, no como cifra puntual semanal.
- Optimización estructural del contenido (GEO/chunking) para maximizar la probabilidad de ser una fuente citable, que es la única palanca sobre la que realmente tenemos control.
Lo que no vamos a hacer es venderte un «ranking en ChatGPT» semanal con una precisión que ni Google, ni OpenAI, ni Anthropic pueden garantizar internamente. Si quieres una auditoría honesta de dónde está hoy tu marca en el ecosistema de IA generativa y qué palancas de contenido puedes mover con impacto real, hablemos.
PREGUNTAS FRECUENTES
¿Existen herramientas fiables para medir la visibilidad en IA?
Existen herramientas útiles, pero ninguna es fiable en el sentido de dar una cifra exacta y reproducible. Las de escala masiva (SISTRIX, Ahrefs, Semrush) aportan señal direccional para detectar gaps de contenido. Las de pocos prompts (25 a 100) tienen un valor estadístico muy limitado, según la evidencia de Anthropic y SparkToro citada en este artículo.
¿Por qué ChatGPT no me recomienda igual dos veces seguidas?
Porque los modelos de lenguaje son probabilísticos por diseño, incluso con configuraciones que se creían deterministas. A esto se suma la personalización según el historial, la ubicación y las herramientas conectadas del usuario que pregunta.
¿Qué es el Share of Voice en IA y por qué no es comparable entre plataformas?
Es el porcentaje de menciones de tu marca frente al total de menciones de marcas rastreadas. No es comparable porque el listado de competidores que se incluye en el cálculo es una decisión arbitraria de quien configura la herramienta, y varía significativamente entre ChatGPT, Copilot o Perplexity.
¿Vale la pena contratar un prompt tracker?
Depende del uso que le des. Como fuente de verdad para un informe mensual de «posición», no. Como herramienta para detectar clústeres temáticos donde tu competencia aparece y tú no, puede aportar valor, especialmente en las plataformas de escala masiva.
¿Qué puedo medir de forma fiable hoy?
Datos de primera parte cuando existen (como Bing AI Performance), tendencias agregadas de aparición a lo largo del tiempo, y gaps de contenido por clúster temático frente a competidores. Todo lo demás debe tratarse como una estimación con margen de error alto.
ARTÍCULOS RELACIONADOS
- ¿Tu contenido es extraíble para la IA? Auditoría de Chunking
- Por qué el SEO tradicional ya no es suficiente en la era de la IA
- GEO, AEO y AIO no son sinónimos. Estas son las diferencias básicas
- SEO para IA: Optimización para Inteligencia Artificial Generativa (AIO). Guía completa
- LLMO. Incorpora tu marca a las respuestas de IA


